专注GEO运营
AI搜索探索者
AI搜索探索者
导航
AI重塑时代用户搜索习惯
传统搜索平台,覆盖广度大,但搜索碎片化且矛盾常见;AI平台,用户粘性较高,占比和影响力正在飞速提升。
AI 搜索会不会取代传统搜索?
AI 搜索会不会取代传统搜索?
AI 搜索会不会取代传统搜索,先看它把哪一步替掉了
先说结论:AI 搜索不会整体取代传统搜索,它接走的是其中一类问题。查航班、查营业时间、找官方入口,搜索引擎和地图仍然更快更准;怎么选、哪家好、为什么,这类开放型的判断,用户已经越来越习惯先问 AI。变化的核心只有一个:筛选从用户手里挪到了模型手里——搜索引擎给一页候选让你自己挑,AI 直接给一段组织好的答案。
朱啸虎在《AI光年》里说得绝对:搜索肯定是被彻底取代了。认同的人有数据,艾瑞咨询 2026 年 2 月的调研里,41% 的受访者几乎完全转向了 AI 搜索;不认同的人也有数据,YouGov 同期在美国的调研里,过去 30 天用过搜索引擎的人占 86%,信任 AI 给出信息的只有 28%。两组结论拧着来,是因为它们测的不是同一类问题——这正是分流的样子。
一、筛选从用户手里挪到了模型手里
在搜索框里提问,第一道功夫花在提问之前:把脑子里那句完整的话压成两三个关键词——「卫生间 瓷砖 怎么选 防滑」。压缩,是替自己翻译。拿到结果页还有第二道:十条候选里,前几条是广告,往下是几篇差不多的导购文,点开四五个页面,自己把说法拼成结论。
对话框里这两道都省了。条件一股脑塞进去——卫生间、有老人、预算多少——模型读句子不挑词,回来的是一段带条件、带理由的答案,不满意接着追问。
省掉筛选的代价,是判断权先过了一遍模型的手。美国市场 68% 的 Google 搜索以零点击结束,出现 AI 摘要的查询里这个数字到 83%;摘要里挂着引用链接,真正点开的只有 1% 左右。但用户没有变轻信:85% 的 AI 使用者看完还会去别处核对。筛选外包了,复核留在了自己手里。
对品牌来说这一步是硬的:传统搜索里用户至少会扫到第十条,AI 的答案压成一段之后,没被写进去的名字,在这次查询里等于不存在。
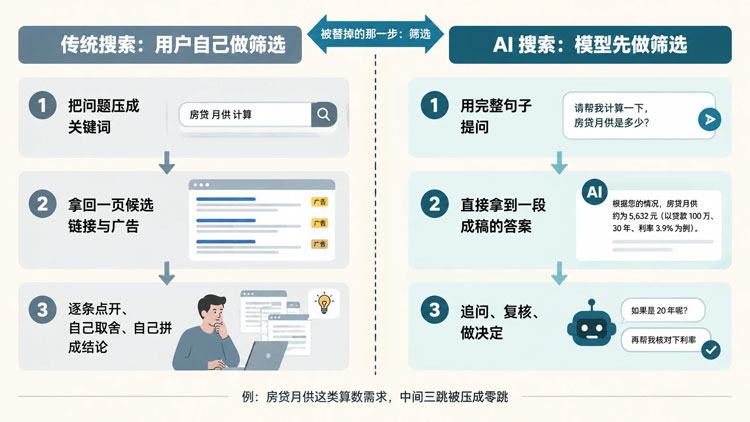
传统搜索与 AI 搜索的流程对比:被替掉的那一步是筛选,例:房贷月供这类算数需求,中间三跳被压成零跳
二、算一个数的需求,被替换得最彻底
「算一个数」这类需求上,替换发生得更彻底。房贷月供、汇率换算、个税、油耗,以前的标准路径是:搜「房贷计算器」→ 从结果页挑一个计算器网站(前面压着聚合站和广告)→ 表单里把金额、年限、利率一格一格填进去 → 拿到一个数字。中间这几跳,每一跳都是那个站点当年靠关键词抢来的流量。
换成对话框,同一句话直接丢进去:「100 万商贷、30 年、年利率 3.5%、等额本息,月供多少」。月供、总利息、每月还款构成一起回来;追问「提前还 20 万能省多少利息」,它接着算。
搜索框自己也会算一部分——单位换算、汇率、「1+1」在结果页顶部直接给。但带参数的它算不了,只能把人送去页面填表单。模型会算,中间那几跳就没有存在的理由了:这类问题用户要的从来不是阅读,是一个数字。
三、说取代不准确,准确的说法是按问题类型分流
把矛盾的两组调研拆开,它们测的本来就不是同一类问题。艾瑞那轮调研里,AI 搜索对用户价值排前三的是「个人效率助手」「复杂问题的整合答案」「理解陌生概念」,全是开放型问题。本地服务那一头变化更陡:BrightLocal 2026 年的调研里,用 AI 找本地服务的消费者一年内从 6% 涨到 45%。用户在分流,不是搬家。
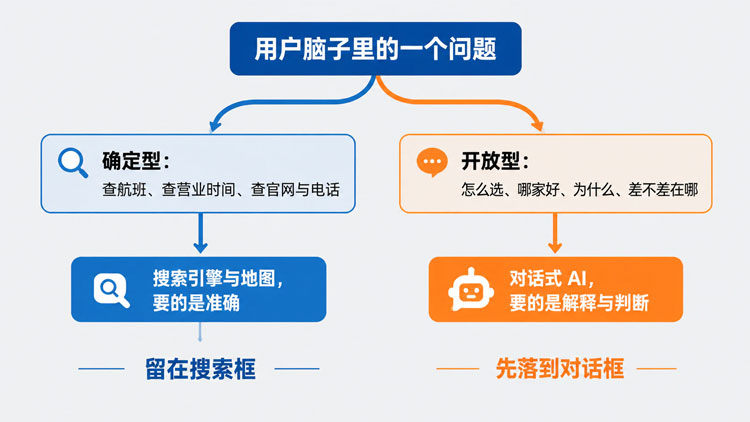
同一个问题按类型分流:确定型留在搜索框,开放型先落到对话框
四、两边的毛病都没消失,只是换了位置
AI 搜索修好了「要自己拼」,带来了几个新毛病。幻觉:模型在不熟的领域会为句子连贯补出不存在的细节,学术参考文献是最典型的翻车区——期刊名是真的,文章查不到。时差:训练数据有截止日期,联网也常抓到旧稿,「AI 给的还是几年前的信息,怎么更新」这句问话本身就说明问题在可控性。答案分岔:有机构统计过 1600 万条 AI 引用,四个模型的信源各有偏好——豆包的前五大信源里三个来自字节系,元宝对公众号可见性更高,DeepSeek 常引知乎和 CSDN,Kimi 偏好公众号长文。同一句话在两个模型里问,措辞、引用的品牌、结论都可能对不上。
传统搜索那头的毛病一条没少:广告挡在结果前面、同质化内容互相抄、答案还得自己拼。一个是你得自己动手,一个是轮不到你动手。
对话式 AI 带来的四个新问题,与传统搜索一直没解决的三个问题:短板不在同一个位置
同一句话,两个模型给出的答案能差出很远
拿一个消费品问句去试:在豆包和 DeepSeek 上各问一遍「XX 这个牌子怎么样」。一个更可能引用到抖音文案、头条文章这类短平快的内容,答案口气偏口语、偏场景;另一个更可能引到知乎的长回答和技术社区的分析,答案偏结构、偏参数。两段答案里的品牌、理由、甚至结论倾向都可能对不上。
这不是某一方出错。模型的检索池不同,从池子里捞出来的片段就不同,组织出来的话自然不同。对品牌来说,这一条直接决定了铺内容的位置要先选哪几个,而不是把同一句话在十几个平台各贴一遍。
五、名额从十个压到两三个,位置的形成方式也变了
传统搜索结果页一页十个位置,排第六也有人看。对话式 AI 给的答案通常两三个名字。名额少到什么程度,SOCi 2026 年的本地可见度指数量过:传统 Google 本地三包覆盖 35.9% 的商家,Gemini 推荐到 11%,Perplexity 7.4%,ChatGPT 只有 1.2%。同一个城市同一批店,能被 AI 说出口的名额少了一个量级。「为什么 AI 推荐的都是大品牌,没有我们这种本地商家」,问的就是这件事。
这两种位置的形成方式也不一样。搜索结果页的名次由排名算法定,排第几都还是个位置;AI 的提名是模型从自己信任的一批来源里,把关于你的说法汇集出来的判断。同一件事在不同地方被说成两个样子,它把你写进回答的理由就少一条。同一个品牌在不同 AI 里待遇可能完全不同——内容落在哪、被谁读到,直接决定它在哪个模型里被提起。
AI 摘要出现时首页点击率掉 58%,答案里的引用链接只有 1% 的人点。「有没有被提到」和「有没有人点进来」已经是两笔账,前一笔的重量在涨。
传统搜索一页十个位置,对话式 AI 的答案里只有两三个名字:没被写进去,这次查询里就不存在
六、回到最初那个问题
不会整体取代,是分流。确定型的查证留在搜索框,开放型的比较和判断先落到对话框,这个迁移还在继续。对品牌来说,入口换了一半,用户手上的判断却没有交出去,而用户判断时看的是有没有能核实的事实。
想让品牌被 AI 准确理解并推荐,企航互联做的就是这件事。
声明:本网站发布的内容(图片、视频和文字)以原创、转载和分享网络内容为主,如果涉及侵权请尽快告知,我们将会在第一时间删除。文章观点不代表本网站立场,如需处理请联系客服。电话:153-3969-8279。
相关资讯
- 豆包AI搜索优化真的有用吗?
- GEO是否只能获取本地客户?探讨篇-安徽GEO服务商
- 安徽中小企业预算有限,先做 SEO 还是 GEO?
- 安徽豆包推广服务商「AI 搜索拆解工具」功能说明与使用方案
- 安徽GEO服务商:原来 AI 一直在“白嫖”我的文章
- 您的客户正在问AI“哪家好”,而您的品牌,可能根本没进备选名单
- 安徽中销企业做GEO最怕的不是慢,是一开始铺太开
- GEO到底是什么?就是让AI“认识您、记住您、推荐您”
- 黑帽GEO优化是怎么做的?什么是黑帽GEO?为什么不能碰
- 如何用GEO发稿平台构建AI信任的品牌护城河?
- GEO是什么?安徽企业如何抓住AI时代的“推荐即信任”红利?
- 新手从0到1入门GEO优化推广的完整实操指南
获客策划更多 >
合肥口腔诊所如何做豆包AI优化推广?实操解答::
发布日期:2026-09-28泵阀管道GEO优化推广!风险处理要先看懂哪些问题?
发布日期:2026-09-22律师事务所如何做AI搜索推广?GEO优化落地策略免费分享:
发布日期:2026-07-12工业品制造公司如何开展GEO优化?完整实操指南
发布日期:2026-09-02美缝施工企业如何做GEO搜索推广?才能被AI推荐给本地业主?
发布日期:2026-09-13猫粮、宠物用品厂家如何做好GEO优化?AI搜索推广建议:
发布日期:2026-07-03马桶制造商家如何做GEO获客?AI搜索策划方案送给您
发布日期:2026-08-03本地除甲醛公司在豆包AI里搜不到?这个问题如何化解?策略分享
发布日期:2026-06-28
