专注GEO运营
AI搜索探索者
AI搜索探索者
导航
AI重塑时代用户搜索习惯
传统搜索平台,覆盖广度大,但搜索碎片化且矛盾常见;AI平台,用户粘性较高,占比和影响力正在飞速提升。
安徽GEO服务商:原来 AI 一直在“白嫖”我的文章
安徽GEO服务商:原来 AI 一直在“白嫖”我的文章
GEO是什么?
2026年,GEO这个词突然跳了出来,尤其是在央视3·15晚会曝光“AI投毒”后。
GEO的全称叫做“Generative Engine Optimization”,翻译过来叫做“生成引擎优化”,顾名思义,和AI的生成有关。
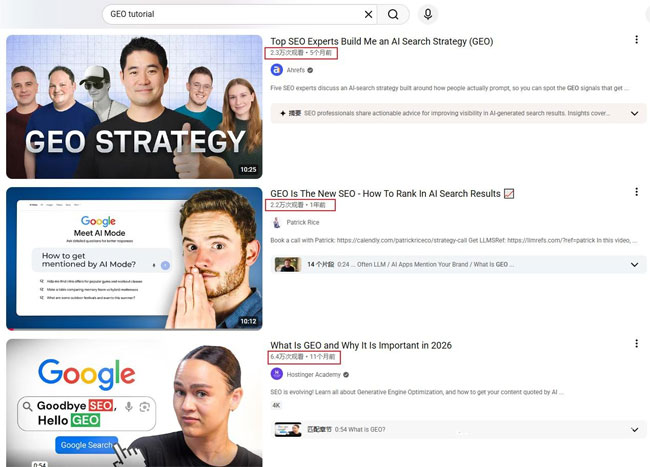
我们现在在国内的社交媒体搜索“GEO” 或者 “GEO教程”,会发现两个特点:一是GEO的教程还很少,相对传统SEO的教程,GEO的相关文章,视频和论坛,可以说少的可怜,更不必说有什么火爆的教程了;二是排名靠前的,被网站推广的GEO教程,基本都是来自2026年。
这就给人一种错觉:GEO是2026年突然跳出来的吗?
其实不是,如果我们通过某种渠道,在国外的社交媒体上搜索“GEO” 或者 “GEO tutorial”,会发现已经有不少数万播放的视频了,而这些视频大部分来自2025年。
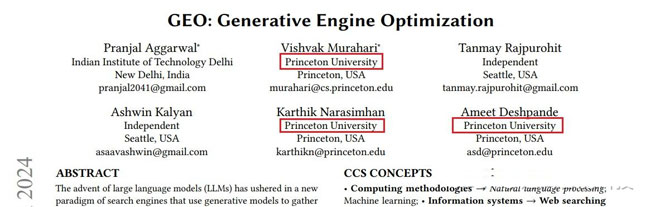
 GEO这个术语,或者说这个概念,最先出现于 2年前 普林斯顿大学发表的一篇论文中,这篇论文的题目就叫做“GEO: Generative Engine Optimization”,也就是直接以GEO来命名论文了,这是GEO这个词首次被正式提及并发布出来,当时是2024年。我们后面会专门去讲这篇论文。
要说到GEO,就不得不先提一嘴SEO (Search Engine Optimization,搜索引擎优化)。两者是一场“名”与“实”的博弈,SEO重“名”,本质是循名责实;GEO重“实”,本质是由实返名。
传统的SEO ,谷歌一下或者百度一下,浏览器会给出多个蓝色链接,不同的链接对应不同的网页,但是不同网页的排名是不一样的,有的高有的低。当我们试图让自己的网站在这些蓝色链接中排名更高时,就称为我们在进行SEO工作。
而GEO,我们不再试图让自己的网站在搜索结果中排名更高,而是希望让自己创作的内容被AI大模型引用,作为回答参考的一部分。我们希望AI可以采用我们的方案,接纳我们的想法,认可我们的表述,融合我们的思维方式。
更重要的是,我们做GEO的目的,是希望 AI 在回答我们或者别人的问题时,能够对我们的内容进行“标记”,给出属于我们的内容的参考链接,而不是被AI“白嫖”。
GEO的工作流程
我做了一张图片:
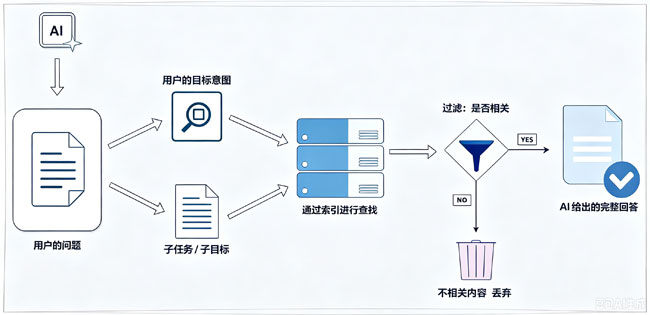
GEO工作原理
当用户向AI问出一个问题时,大模型首先会分析用户的问题。
分析完毕之后,大模型会提取出用户问这个问题的意图,然后拆解出可能的子任务 或者 子目标。
接着,大模型会通过索引对内容进行查找,这里的内容可以是自己训练时的语料库(这部分内容模型相当于已经背下来了),也可以是模型联网搜索到的内容,还可以是通过RAG等技术获取的外部知识库中的内容。
然后,大模型会有一个类似于 Filter(过滤器)的这么一个机制,就是判断自己找到的这些内容 和 之前拆解用户问题得到的 意图以及子任务/子目标 是否相关,如果其中一部分内容判断为相关,大模型就会借助这些内容来进行文本生成;如果判断结果是不相关,那么在本次回答中,不相关的内容就会被大模型舍弃掉。这里判断是否相关,大模型会综合不同的因素,例如信任度、知名度,内容的质量高低,等等。
对于最终的生成结果,大模型可能会给出参考文献,可能会给出具体的消息源对应的链接;也有些时候,大模型会直接给出最终的生成结果,而没有附带任何的参考链接。
这里面就有一个问题,虽然大模型总是会借助“判断为相关的内容”来生成回答,但是这并不意味着大模型在每次回答时一定会给出引用参考,给出具体的消息源。有时候你的内容明明被大模型引用了,但是它可能没有给出链接对你进行标注。这个时候,就可以说,你的内容被AI“白嫖”了。
换句话说,你在各个平台创作的内容,可能会时不时地被不同的大模型所查看,所检索,所总结,所引用,但是不一定会被标注,就是说大模型可能会“白嫖”你的内容,在引用了你的内容后却没有去给出一个链接,去告诉读者朋友们:我这次的回答可是引用了某某某的文章噢。
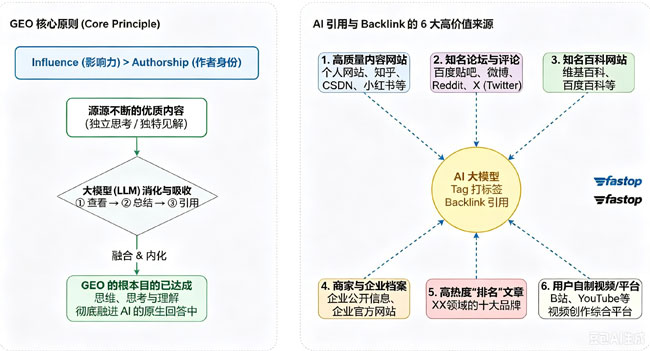
GEO的核心原则
这就牵扯出了在GEO中很重要的一个概念,那就是Influence(影响力)> Authorship(作者身份),意思就是说,如果我进行了优质内容的创作,并且我还在源源不断地产出优质内容,那么只要我的内容被大模型查看、总结、并引用,即便它最后没有给出我的内容的链接,我也达到了我的根本目的。因为AI已经将我的思维,我的思考,我的理解融合进了它的回答里面。
至于怎么让AI 大模型更容易对我们的内容打出一个 Tag,给出一个具体的backlink(反向链接) 去指向我们的内容。我们就必须了解 AI引用的内容来自哪里?
首先是高质量,高认可度,高知名度的内容网站,可以是你的个人网站,也可以是一些平台网站,比如知乎、CSDN、小红书等。
然后是一些知名论坛上的帖子,包括帖子下面的评论,比如百度贴吧,微博,Reddit,X等。
也可以是一些知名的百科网站,例如百度百科,维基百科等。
也可以是一些商家档案,比如企业公开展示的信息、企业的官方网站等。
也可以是一些写“排名”的高热度文章或者官方的排名,比如“最好用的十个XXX产品”,“XX领域最牛的五家头部公司”,“某某地区最棒的XX领域的公司”,等等。
不同用户自己创作的内容,例如一些视频网站或者平台。
所以,如果我们只是去写一些高质量的帖子、博客,那么我们就可能丢失了一半的GEO领域。如果条件允许,同时去创作优质的文章和视频,可以更好地帮助我们进行GEO工作。
那么,在了解了AI引用的内容来自哪里后,我们就可以为自己的GEO工作添砖加瓦了!我们需要去这么干:
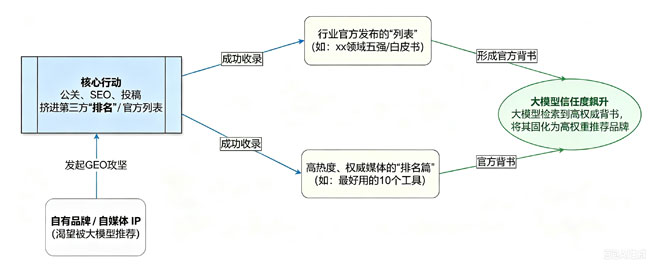
1、争取进入“排名”相关的文章或者帖子,尤其是官方给出的“列表”,因为进入官方给出的列表可以有很好的背书效果,会提高大模型对你的品牌或者IP的信任度。
2、持续在个人网站或者其他主流网站上创作优质内容。靠着短期给AI“喂shit”是不可取的,因为现在的大模型很聪明,它们很容易就可以辨别你的文章是高质量的优质文章,还是低质量的灌水文章。如果你想通过短期的投喂大模型很多垃圾内容来提高你自己品牌的GEO,抱歉,短期内可能略有效果,但是时间线一拉长,立马就没影儿了,大模型直接给你降低权重,你发再多都没用。所以要坚持长期地创作优质内容。
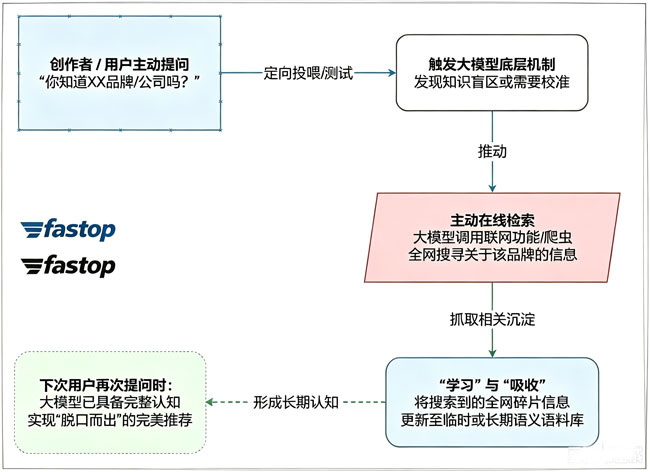
3、可以主动问问大模型,你知道XX品牌,XX公司吗?这样的话会推动大模型去主动检索相关信息,促进大模型对你的品牌的“学习”和“吸收”。
4、设法让自己的品牌内容“被提及”,因为像是ChatGPT这种AI在回答的时候是会读取一些在线网站的内容的,如果你的内容就挂在网站上,或者被一些知名网站“提及了”,那么大模型就会认为你的内容是“可信任的”。
5、好的SEO是可以促进GEO的,因为大模型如果开启了联网功能,它也会去搜索引擎主动搜索,然后扒一下内容下来。所以,要么就优化你个人网站的SEO,要么就去SEO做的好的网站上持续发布优质内容,两者都是可行的。
6、利用“长尾效应”,创作更多别人不创作的内容,例如某些复杂的但又很具体的问题。
了解了这些后,我想你一定可以做好GEO了。虽然GEO重“实”,本质是由实返名,但是我们还是要想办法让大模型尽可能地去“标记”我们,毕竟“生存是文明的第一需要”。
声明:本网站发布的内容(图片、视频和文字)以原创、转载和分享网络内容为主,如果涉及侵权请尽快告知,我们将会在第一时间删除。文章观点不代表本网站立场,如需处理请联系客服。电话:153-3969-8279。
相关资讯
- 您的客户正在问AI“哪家好”,而您的品牌,可能根本没进备选名单
- 安徽中销企业做GEO最怕的不是慢,是一开始铺太开
- GEO到底是什么?就是让AI“认识您、记住您、推荐您”
- 黑帽GEO优化是怎么做的?什么是黑帽GEO?为什么不能碰
- 如何用GEO发稿平台构建AI信任的品牌护城河?
- GEO是什么?安徽企业如何抓住AI时代的“推荐即信任”红利?
- 白帽GEO与黑帽GEO的区别在哪里?安徽合规GEO实操服务商
- GEO说到底是提高AI对您的信任度_合肥GEO服务商
- 企航互联 GEO 优化的基本流程:从规划到落地的完整步骤
- GEO推广的终极战场,是抢占AI对品牌的“理解权”
- GEO vs 黑帽GEO_企业品牌在AI时代的正确选择
- 科普 GEO 优化:搞懂定义与 GEO、SEO 之间的区别
获客策划更多 >
律师事务所如何做AI搜索推广?GEO优化落地策略免费分享:
发布日期:2026-07-12工业品制造公司如何开展GEO优化?完整实操指南
发布日期:2026-09-02美缝施工企业如何做GEO搜索推广?才能被AI推荐给本地业主?
发布日期:2026-09-13泵阀管道GEO优化推广!风险处理要先看懂哪些问题?
发布日期:2026-09-22本地除甲醛公司在豆包AI里搜不到?这个问题如何化解?策略分享
发布日期:2026-06-28马桶制造商家如何做GEO获客?AI搜索策划方案送给您
发布日期:2026-08-03猫粮、宠物用品厂家如何做好GEO优化?AI搜索推广建议:
发布日期:2026-07-03合肥口腔诊所如何做豆包AI优化推广?实操解答::
发布日期:2026-09-28
